Hoe optimaliseert u uw aanwezigheid op ChatGPT? Door het snel ladende HTML-content te geven, perfect gestructureerd in zelfstandige blokken van 150 woorden, toegankelijk via uw robots.txt-machtigingen, en ondersteund door sterke autoriteit buiten uw site. Dat is de essentie van GEO. Makkelijk gezegd — maar hoe pakt u dat in de praktijk aan?
“Zoeken is niet langer alleen ‘zoeken.’”
In slechts enkele maanden is ChatGPT een volwaardig zoekkanaal geworden voor uw kopers, zowel B2B als B2C. Om dit nieuwe soort verkeer te vangen, ontdekt u in onze ChatGPT-optimalisatiegids hoe u uw merk centraal positioneert in AI-antwoorden. Deze gids is opgebouwd rond drie pijlers: technisch, semantisch en autoriteit. In de kern zijn dit dezelfde drie pijlers waarop een ervaren SEO-expert al werkt. Wat verandert met generatieve zoekopdrachten — en met ChatGPT in het bijzonder — is de manier waarop u ze activeert. Daarvoor kunt u steunen op onze GEO-methodologie in 6 stappen. ChatGPT beschikt (nog, en niet uitsluitend) niet over een eigen zoekindex die zo volwassen is als die van Google: lange tijd afhankelijk van Bing, steunt het nu op een mix van externe dataleveranciers en een eigen index die nog in opbouw is (zie de technische sectie hieronder). Dit andere ontdekbaarheidsmechanisme — onstabieler, minder gedocumenteerd, snel evoluerend van de ene modelupdate naar de andere — verandert de manier waarop u elk van de drie pijlers aanpakt, en daar gaat deze gids precies over. Drie pijlers, drie doelstellingen: Technisch — bereikbaar zijn. Botmachtigingen, server-side rendering, snelheid, productfeeds: de ruwe toegangsvoorwaarden tot uw content. Semantisch — begrepen worden. Clusterstructuur, extraheerbare formats en herkenning van uw merk als entiteit. Autoriteit — geciteerd worden. De vertrouwens- en reputatiesignalen die ervoor zorgen dat een model u onthoudt — en aanbeveelt.
Vandaag bestaan er vier afkortingen naast elkaar — SEO, AIO, AEO, GEO — elk met verschillende doelstellingen, hefbomen en meetwaarden. Een verwarring die zelfs in marketing-stuurgroepen regelmatig opduikt.
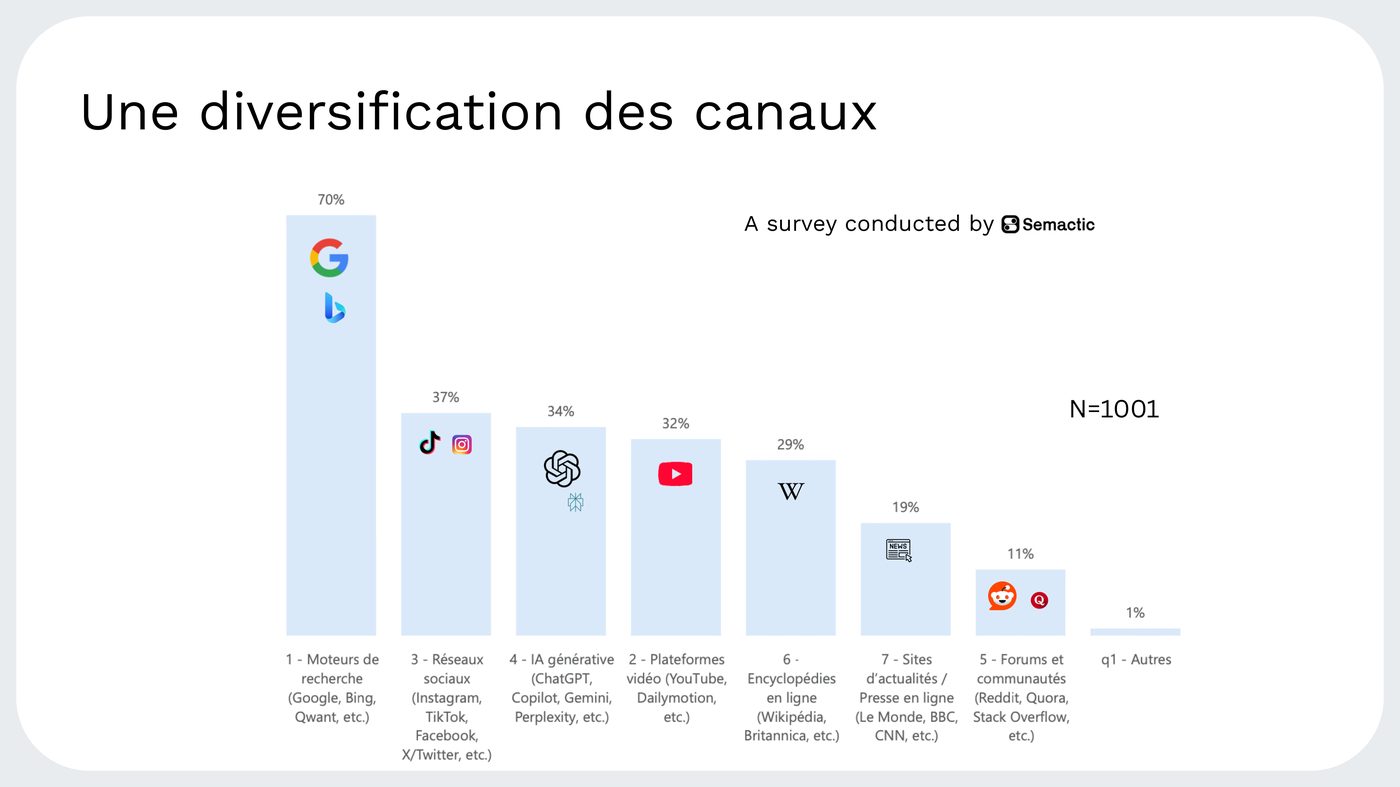
Hoe mensen vandaag online zoeken — Semactic-onderzoek, panel n = 1.001, meerdere antwoorden mogelijk.
Een cijfer om mee te beginnen vóór we het onderscheid SEO/LLM SEO/GEO bespreken: op dit panel blijven traditionele zoekmachines (Google, Bing) het meest genoemde kanaal (70%) — maar generatieve AI (ChatGPT, Copilot, Gemini, Perplexity) staat al op de 3e plaats (34%), net achter sociale media (37%) en vóór videoplatformen (32%). Samen overtreffen sociale media en generatieve AI (71%) op dit panel al de traditionele zoekmachines.
Twee kanttekeningen zijn nodig om dit cijfer correct te lezen. Ten eerste is het onderzoek al een jaar oud: in een sector die van maand tot maand verandert, is het zeer aannemelijk dat het aandeel van generatieve AI sindsdien verder is gegroeid. Ten tweede — en dit is wellicht het belangrijkste punt — vervaagt de grens tussen een “traditionele zoekmachine” en een “AI-antwoord” zelf, naarmate Google zijn AI Overviews breder uitrolt en AI Mode nu al standaard integreert in klassiek zoeken: een deel van wat nog als “Google-zoekopdracht” telt, is in de praktijk al een generatief antwoord. Deze kanalen als volledig gescheiden beschouwen is dus deels al een meetartefact — wat de noodzaak om SEO, LLM SEO en GEO duidelijk van elkaar te onderscheiden alleen maar versterkt.
“Klassieke” SEO optimaliseert een pagina zodat ze verschijnt tussen de organische links van een zoekmachine (Google, Bing): zoekwoorden, interne links, domeinautoriteit, positie op de resultatenpagina. De meeteenheid is de ranking, en het einddoel blijft de klik.
LLM SEO (ook wel AI SEO genoemd) verwijst naar optimalisatie stroomopwaarts: content geschikt maken voor de training van de taalmodellen zelf — het terrein van GPTBot. Een hefboom voor de lange termijn, met vertraagde effecten die moeilijk campagne per campagne te meten zijn, aangezien ze inwerken op het “parametrische” geheugen van het model in plaats van op één specifiek antwoord.
Niet te verwarren met AIO (AI Optimization), een recentere term voor het gebruik van AI-tools om content te produceren en te industrialiseren — ideeën, ondersteund schrijven, geautomatiseerde kwaliteitscontrole — een productiebenadering, geen zichtbaarheidsstrategie op zich.
AEO (Answer Engine Optimization) mikt op onmiddellijke opname in een gegenereerd antwoord: content structureren — gestructureerde data, vraag/antwoord-formulering, natuurlijke taalverwerking — zodat het wordt overgenomen als hét antwoord, in featured snippets, “Andere veelgestelde vragen” en de AI Overviews van zowel Google als Bing.
GEO (Generative Engine Optimization) is de breedste van de drie: het omvat contentstrategie, datastructurering en toegankelijkheid, maar ook reputatiesignalen en de externe geloofwaardigheid van het merk — zodat het wordt erkend als referentie, geciteerd en aanbevolen in AI-gegenereerde content, niet enkel erin aanwezig is. AIO, AEO en LLM SEO zijn geen concurrerende benaderingen: het zijn complementaire lagen van dezelfde discipline. Zoals een Semactic-artikel over het onderwerp het samenvat: u hoeft niet langer goed gerangschikt te staan, u moet hét antwoord zijn.
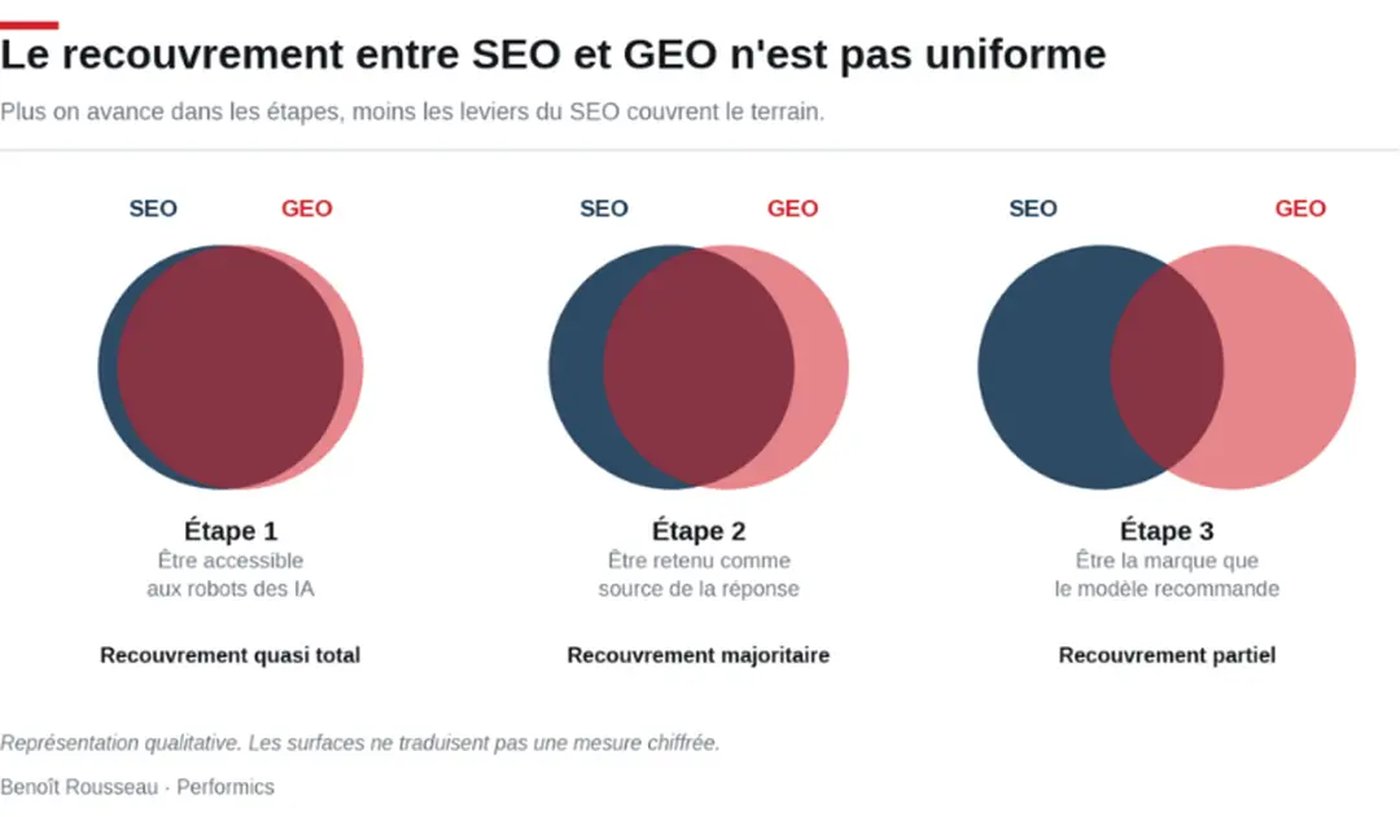
De overlap tussen SEO en GEO is niet uniform: ze neemt af naarmate u door de fasen beweegt. Analyse door Benoît Rousseau · Performics.
Deze indeling in drie fasen is nuttiger dan een binaire tegenstelling SEO/GEO: in fase 1 (toegankelijk zijn voor AI-crawlers) dienen de technische randvoorwaarden van SEO — crawlbaarheid, snelheid, architectuur — bijna volledig ook GEO. In fase 2 (behouden worden als bron voor het antwoord) blijft de overlap grotendeels behouden, maar maakt semantische structurering het verschil. In fase 3 (het merk zijn dat het model aanbeveelt) wordt de overlap gedeeltelijk: een positie in een SERP garandeert niets meer — enkel de autoriteit die het model waarneemt, telt.
Kort samengevat, in drie punten:
SEO verdwijnt niet: het blijft de basis van de drie pijlers in deze gids. Wat verandert, is hoe u ze prioriteert zodra u van ranking naar citatie overstapt.
Hoe ChatGPT werkelijk zoekt, wat we vandaag weten over de indexeringsmechaniek, en wat u moet controleren om niet uitgesloten te worden nog voor u geëvalueerd wordt.
De logica van generatief zoeken. De cyclus valt uiteen in vijf stappen, ongeacht de generatieve engine: er wordt een vraag gesteld; het model herformuleert die tot een lijst subvragen en relevante criteria; er wordt een live zoekopdracht op het web uitgevoerd; de opgehaalde content wordt gesynthetiseerd, waarbij enkel de essentie van de oorspronkelijke context overblijft; er wordt een antwoord gegenereerd, samen met bronnen en links.
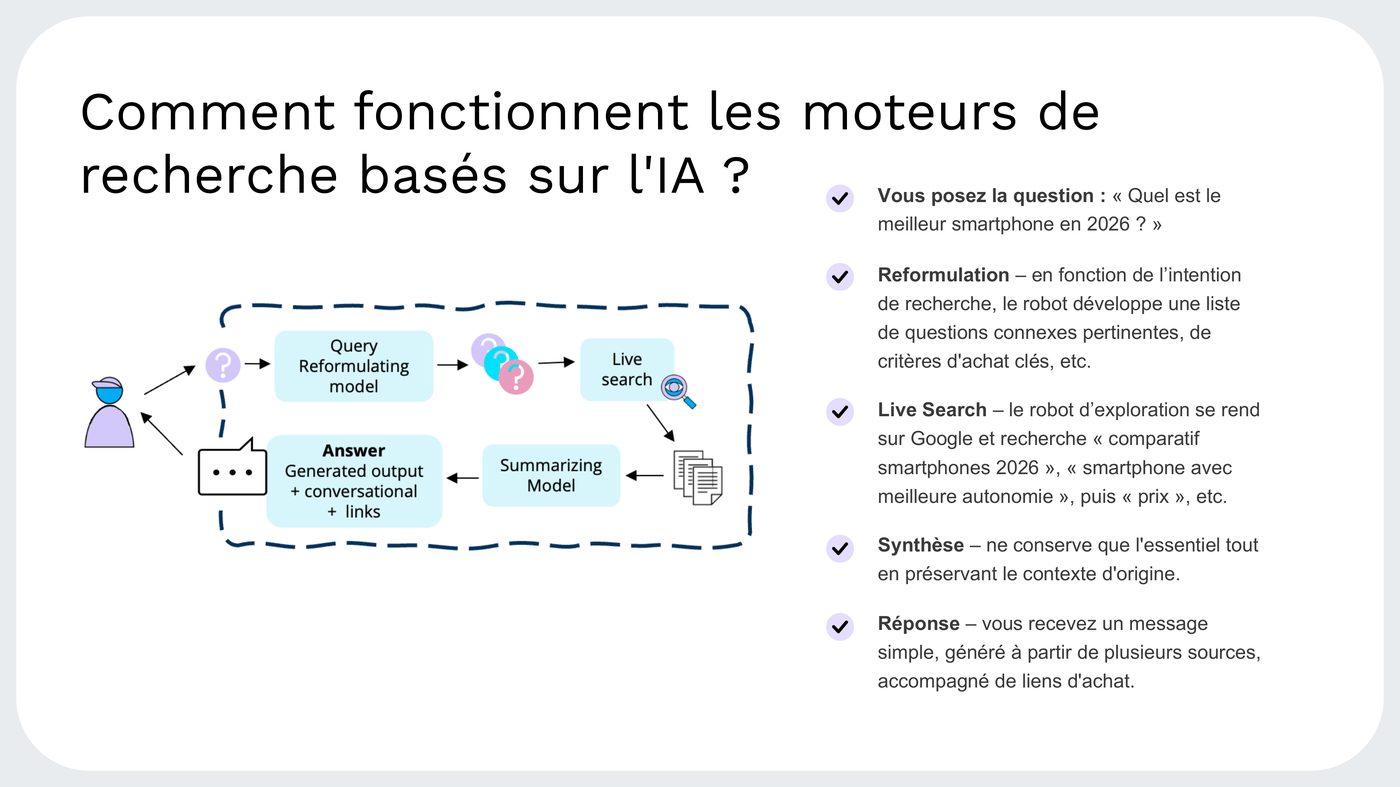
De vijf-stappen-cyclus van een generatieve zoekmachine.
Wat fundamenteel verandert ten opzichte van klassieke SEO: het model reageert nog voordat een gebruiker ook maar ergens op klikt. Het gaat niet langer om ranking, maar om aanwezigheid — aanwezigheid op het juiste moment in de cyclus: herformulering, ophaling, of finale synthese.
Hier wijkt ChatGPT het scherpst af van andere generatieve engines — en hier is de situatie in 2026 het meest veranderd. Bijna twee jaar lang was de gangbare werkhypothese in de SEO/GEO-sector eenvoudig: ChatGPT heeft geen eigen index, besteedt het zoeken uit aan Bing (en, deels, aan externe leveranciers), en herformuleert de vraag van de gebruiker tot één of meerdere klassieke zoekopdrachten — een mechanisme dat de sector “query fan-out” noemde.
Die hypothese moet vandaag genuanceerd worden. Verschillende aanwijzingen, gedocumenteerd doorheen 2026, wijzen in dezelfde richting:
web.run”) orkestreert meerdere golven van zoekopdrachten per antwoord — van 2-3 voor snelle modellen tot 10 of meer voor modellen met diepgaande redenering — waarbij de zoekopdracht bij elke iteratie wordt verfijnd in plaats van één enkele engine te bevragen.De meest voorzichtige consensus, medio 2026: ChatGPT beschikt niet over een eigen index die zo volwassen is als die van Google, maar hangt ook niet langer af van één externe engine. Het orkestreert een evoluerende mix van gespecialiseerde dataleveranciers (algemeen zoeken, shopping, nieuws, lokaal, kaarten…) en een nog gedeeltelijke interne index — wat de waargenomen volatiliteit van model tot model verklaart: een versiewissel kan het aantal unieke domeinen dat in antwoorden wordt geciteerd met meer dan 20% doen schommelen.
Praktisch gevolg. Twee zichtbaarheidsniveaus bestaan naast elkaar, en content die afwezig is op het eerste niveau bereikt nooit het tweede: parametrische zichtbaarheid (bestaat uw merk in de trainingsdata van het model — pers, Wikipedia, autoriteitswebsites?) bepaalt of uw domein überhaupt in aanmerking komt voor een zoekopdracht; dynamische zichtbaarheid (realtime ophaling) bepaalt vervolgens of de content ook effectief wordt geëxtraheerd. Enkel de tweede optimaliseren zonder aan de eerste te werken, is als de etalage poetsen van een winkel die niemand weet te vinden.
Verificatiemethode: open chatgpt.com, activeer de ontwikkelaarstools van uw browser (F12), selecteer het tabblad Netwerk, stel een vraag die een webzoekopdracht triggert, en zoek in de API-respons naar het veld search_model_queries — dit bevat de exacte zoekopdracht die naar de onderliggende engine wordt gestuurd, vaak veel specifieker dan de oorspronkelijke vraag (“wat is een goede gezins-SUV om in de stad te rijden?” wordt “beste gezins-SUV stadsgebruik reviews”). Het is deze geherformuleerde zoekopdracht, niet de oorspronkelijke vraag, die bepaalt welke pagina’s worden opgehaald.
Vier voorwaarden bepalen de ruwe toegang tot uw content, nog voor er sprake is van redactionele kwaliteit:
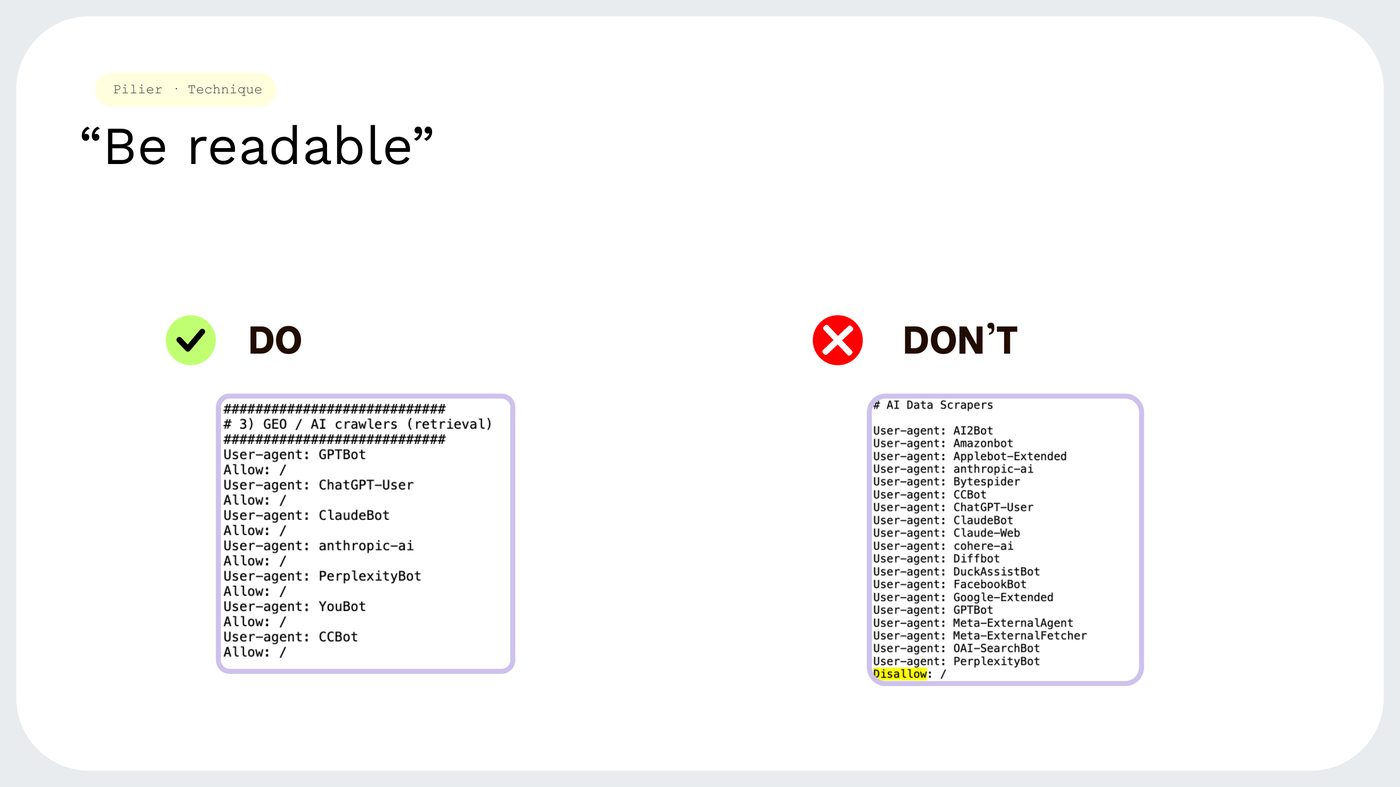
Aanbevolen versus risicovolle configuratie voor AI-retrievalbots.
# Generatief zoeken toestaan (GEO / retrieval)
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /

# Te beslissen op basis van uw beleid rond modeltraining
User-agent: GPTBot
Allow: /   # of Disallow: / als u training op uw content weigert
robots.txt is slechts een intentieverklaring: een WAF of CDN (Cloudflare voorop) kan deze user-agents stroomopwaarts blokkeren, onafhankelijk van het bestand. Laat beide lagen controleren, met schriftelijke bevestiging van uw bureau of infra-team — niet enkel een “dat zou in orde moeten zijn.”
Sinds 2025 biedt OpenAI handelaars een productfeedprogramma aan dat rechtstreeks de zoek- en productontdekkingsfuncties binnen ChatGPT voedt, met — afhankelijk van de markt en de geschiktheid van de handelaar — een geïntegreerde afrekenoptie. In plaats van te vertrouwen op passieve indexering van uw productpagina’s, stuurt u zelf een gestructureerde feed (titels, prijzen, voorraad, media) via HTTPS naar een eindpunt van OpenAI, in CSV-, TSV-, XML- of JSON-formaat. Een eerste steekproef valideert de conformiteit voor livegang; eenmaal gevalideerd, kunnen updates tot elke 15 minuten worden doorgestuurd.
Voor een Mid-Market-merk dat al beschikt over een Google Merchant Center- of Meta Catalog-feed, is de integratie-inspanning beperkt. De geïntegreerde afrekenoptie, waar beschikbaar, brengt wel extra vereisten met zich mee — integratie conform het agentische handelsprotocol van OpenAI en een geverifieerde betalingsprovider. Een project voor e-commerce en IT samen, geen marketingvinkje.
Zodra uw content bereikbaar is, moet ze nog georganiseerd worden zodat ze kan worden geëxtraheerd, geciteerd en ondubbelzinnig aan uw merk gekoppeld.
Een LLM “leest” een pagina niet zoals een bezoeker: het extraheert eruit, vaak in fragmenten, zonder garantie dat het hele document wordt doorlopen. De structuur die deze gefragmenteerde lezing het best dient, is de topic-clusterarchitectuur: een pilaarpagina die een onderwerp samenvat, gekoppeld aan satellietpagina’s die elk facet grondig behandelen. Deze structuur laat een model toe zich door uw corpus te bewegen in plaats van te stoppen bij de eerste gevonden pagina.
Op de schaal van een multi-market Mid-Market-organisatie kan deze structurering niet pagina per pagina worden aangepakt: het vereist een contentsjabloon dat systematisch wordt toegepast in het CMS, een dekkingsaudit per cluster, en duidelijke governance over de versheid van content — een zichtbare, en échte, laatst-bijgewerkt-datum.
Een generatief model geeft de voorkeur aan zelfstandige contentblokken: een betekeniseenheid die op zichzelf compleet is en niet afhankelijk is van de vorige alinea om begrepen te worden.
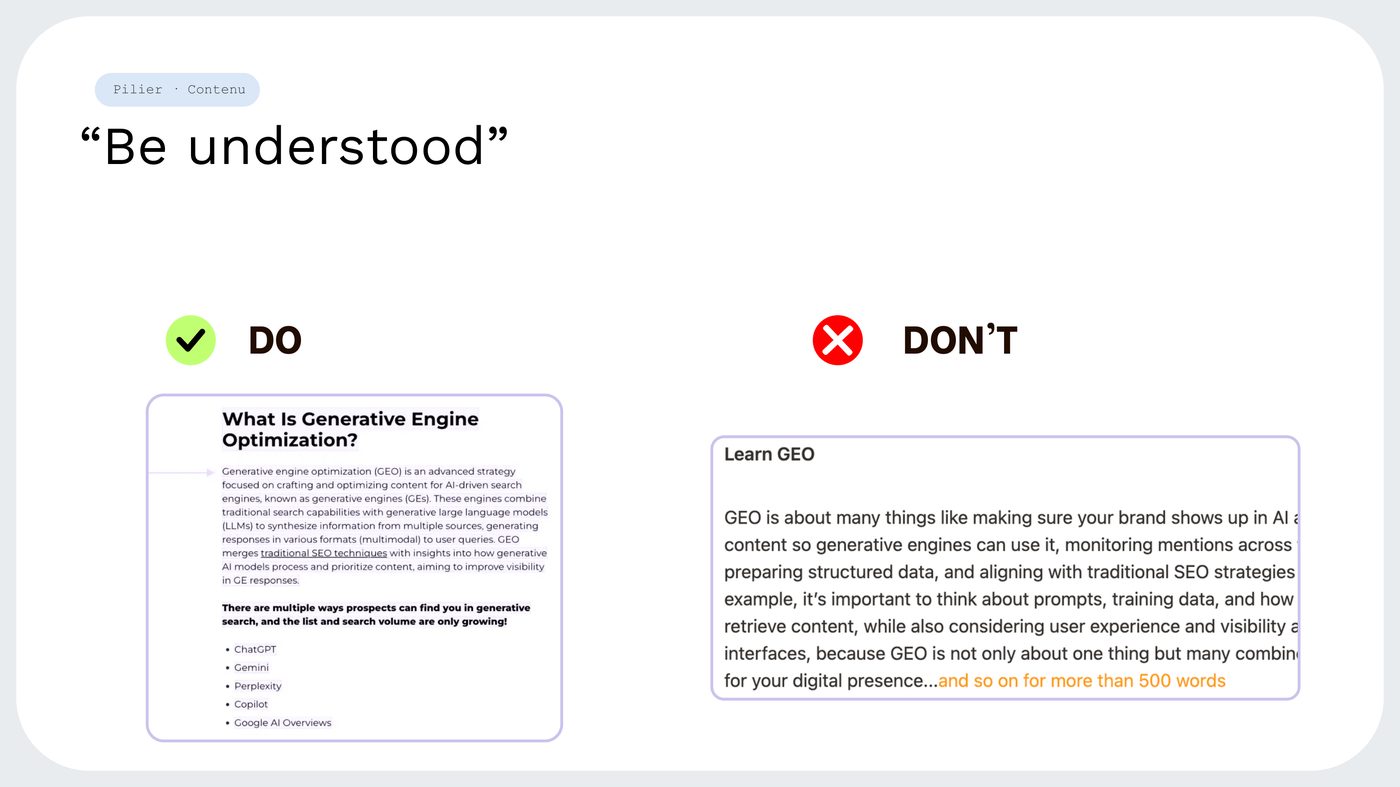
Een gestructureerd, zelfstandig blok (links) tegenover een dichte muur van 500 woorden (rechts).
Een generatief model werkt niet met zoekwoorden, maar met entiteiten: gedesambigueerde identiteiten gekoppeld aan de Knowledge Graph van Google via een unieke identificator (KGMID). Een vage entiteit — een naam die met iemand anders wordt gedeeld, attributen die van site tot site inconsistent zijn — snijdt de zichtbaarheid gewoonweg af, of erger, leidt de waarde naar de verkeerde identiteit. Het gedocumenteerde geval van Danny Goodwin, wiens professionele identiteit tien jaar lang versmolten bleef met die van een honkbalspeler uit de Hall of Fame in de Knowledge Graph, illustreert de reële kost van een slecht vastgelegde entiteit: het volledig verdwijnen van het Knowledge Panel.
Drie voorwaarden laten een AI-engine toe een entiteit — merk of leidinggevende — correct te herkennen:
In de praktijk: bouw een “Entity Home” — een referentiepagina met expliciete schema.org Person- of Organization-markup, die opent met een ondubbelzinnige samenvatting (“[Naam] is [Titel] bij [Organisatie]”) — en creëer vervolgens een corroboratielus (sociale profielen en professionele directories met sameAs-markup, consistente naam/adres/telefoon, persvermeldingen) die naar deze pagina verwijst met identieke kenmerken. Reken op ongeveer 4 maanden voor de toekenning van een stabiele entiteitsidenticator, en tot 12 maanden voor een volledig gestabiliseerde herkenning.
sameAs)De pijler die het vaakst wordt onderschat — en de meest bepalende, naarmate generatieve engines hun citaties concentreren op een kleiner aantal bronnen.
De technische pijler maakt content bereikbaar, de semantische pijler maakt ze begrijpelijk — maar geen van beide garandeert dat een generatief model ervoor kiest deze te citeren boven een even goed gestructureerde concurrent. Dat is de rol van autoriteit: de externe vertrouwenssignalen die ervoor zorgen dat een model de ene bron boven de andere behoudt.
Het referentieonderzoek over dit onderwerp — de baanbrekende studie “Generative Engine Optimization” van Princeton en IIT Delhi (Aggarwal et al.) — mat experimenteel het effect van verschillende hefbomen op de zichtbaarheid van een bron in een gegenereerd antwoord: het toevoegen van verifieerbare citaten en statistieken blijft, in hun metingen, een van de meest effectieve individuele hefbomen, vóór het louter toevoegen van zoekwoorden. Met andere woorden: content die haar bronnen citeert en haar beweringen met cijfers onderbouwt, wordt mechanisch beter onthouden dan onderbouwd noch gestaafde, stellige content — het tegenovergestelde van veel schrijfgewoonten in marketing.
Deze vaststelling sluit aan bij een trend die in 2026 specifiek bij ChatGPT wordt waargenomen: bij elke modelupdate neemt het gemiddelde aantal unieke domeinen dat per antwoord wordt geciteerd af, ten voordele van een kleiner aantal bronnen die als meest betrouwbaar worden beschouwd — een fenomeen dat sommige sectorprofessionals het “Bigfoot-effect” noemen (iedereen praat erover, weinig concrete bronnen documenteren het daadwerkelijk). Een direct gevolg: een correcte bron zijn volstaat niet langer; u moet een bron zijn wiens autoriteit al elders is gevestigd nog voor de zoekopdracht plaatsvindt.
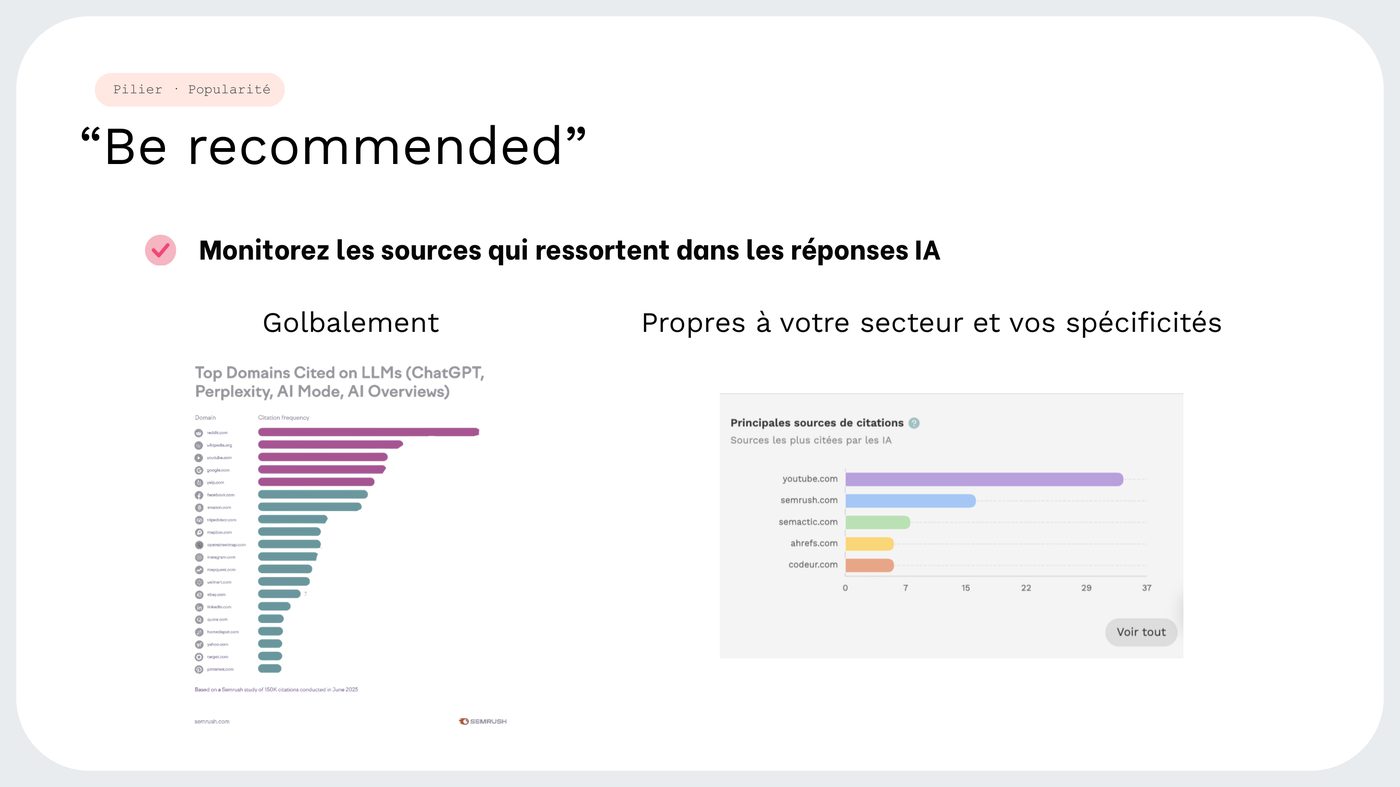
Meest geciteerde domeinen in AI-antwoorden — Semrush-onderzoek, 150.000 citaties, juni 2025.
Dit onderzoek bevestigt dat de meest geciteerde domeinen wereldwijde platformen (Reddit, Wikipedia, YouTube) mengen met sector-specifieke autoriteitssites — een plek die een Mid-Market-merk binnen zijn eigen sector kan innemen, zonder te moeten concurreren met de reuzen van generieke rankings. Dit is des te strategischer omdat 2027, op basis van investeringssignalen aan de kant van OpenAI (eigen indexering, gespecialiseerde verticals), de selectiviteit van weerhouden bronnen nog verder zou moeten aanscherpen in plaats van versoepelen.
Een routekaart die, in volgorde, de drie pijlers uit deze gids overloopt — en de plaats van klassieke SEO in dat geheel.
search_model_queries), wat ChatGPT effectief ophaalt en toont van uw pagina’s.Stappen 4, 5 en 6 verlopen in een korte lus, herhaald cluster per cluster, eerder dan als één enkele sequentie: dit is doorlopend werk, geen project met een einddatum.
SEO verdwijnt niet: op het Semactic-panel blijven traditionele zoekmachines het meest gebruikte kanaal (70%), ver vóór generatieve AI (34%). De fundamenten van goede SEO — domeinautoriteit, interne links, versheid, crawlbaarheid — zijn precies wat de drie pijlers uit deze gids voedt. Tegenover concurrenten met grotere budgetten of meer merkbekendheid blijven twee hefbomen binnen bereik van een Mid-Market-organisatie: sectorale of geografische focus (grondig ingaan op een specifiek segment in plaats van een generieke markt te viseren), en een duidelijke differentiatie, consistent herhaald doorheen de content in plaats van verwaterd in een consensusboodschap als “wij bieden kwaliteitsservice aan al onze klanten.”
Ter illustratie: Daikin, marktleider in HVAC in België, vertrouwde Semactic de herstructurering van zijn technische content voor generatief zoeken toe — een topic-clusteraanpak, zelfstandige contentblokken (≤150 woorden), multimodale content en continue updates. Resultaat: een toegenomen citatie als bron in ChatGPT en Perplexity op de belangrijkste zoekopdrachten van de sector, zonder dat de traditionele SEO van het merk daarvoor moest worden opgeofferd. Bekijk de volledige case study →