Comment optimiser votre présence sur ChatGPT ? En lui fournissant un contenu html rapide à charger, parfaitement structuré en blocs autonomes de 150 mots, accessible via vos autorisations robots.txt, et soutenu par une forte autorité hors-site. C'est l'essence même du GEO. Facile à dire, mais en pratique?
« Search is no longer just “search.” »
En quelques mois, ChatGPT est devenu un point d'entrée de recherche à part entière pour vos acheteurs - B2B comme B2C. Pour capter ce trafic d'un genre nouveau, découvrez notre guide d'optimisation pour ChatGPT afin de positionner votre marque au cœur des réponses de l'IA. Trois piliers structurent ce guide : technique, sémantique et autorité. Ce sont, au fond, les mêmes trois piliers qu'un SEO mature travaille déjà. Ce qui change avec la recherche générative — et singulièrement avec ChatGPT — c'est la façon de les activer. Pour y parvenir, vous pouvez vous appuyer sur notre méthodologie de Generative Engine Optimization en 6 étapes. ChatGPT ne dispose pas (encore, et pas exclusivement) d'un index de recherche propriétaire aussi mûr que celui de Google : longtemps adossé à Bing, il s'appuie aujourd'hui sur un ensemble de fournisseurs de données tiers et un index maison encore en construction (voir plus bas, section technique). Cette mécanique différente de découvrabilité — plus instable, moins documentée, en évolution rapide d'une mise à jour de modèle à l'autre — redistribue la façon d'aborder chacun des trois piliers, et c'est précisément l'objet de ce guide. Trois piliers, trois objectifs : Technique — être atteignable. Autorisations robots, rendu serveur, vitesse, flux produit : les conditions d'accès brutes à votre contenu. Sémantique — être compris. Structuration en clusters, formats extractibles, et reconnaissance de votre marque comme entité. Autorité — être cité. Les signaux de confiance et de réputation qui font qu'un modèle vous retient — et vous recommande.
Quatre sigles cohabitent aujourd'hui — SEO, AIO, AEO, GEO — avec des objectifs, des leviers et des indicateurs différents. Une confusion fréquente jusque dans les comités de pilotage marketing.
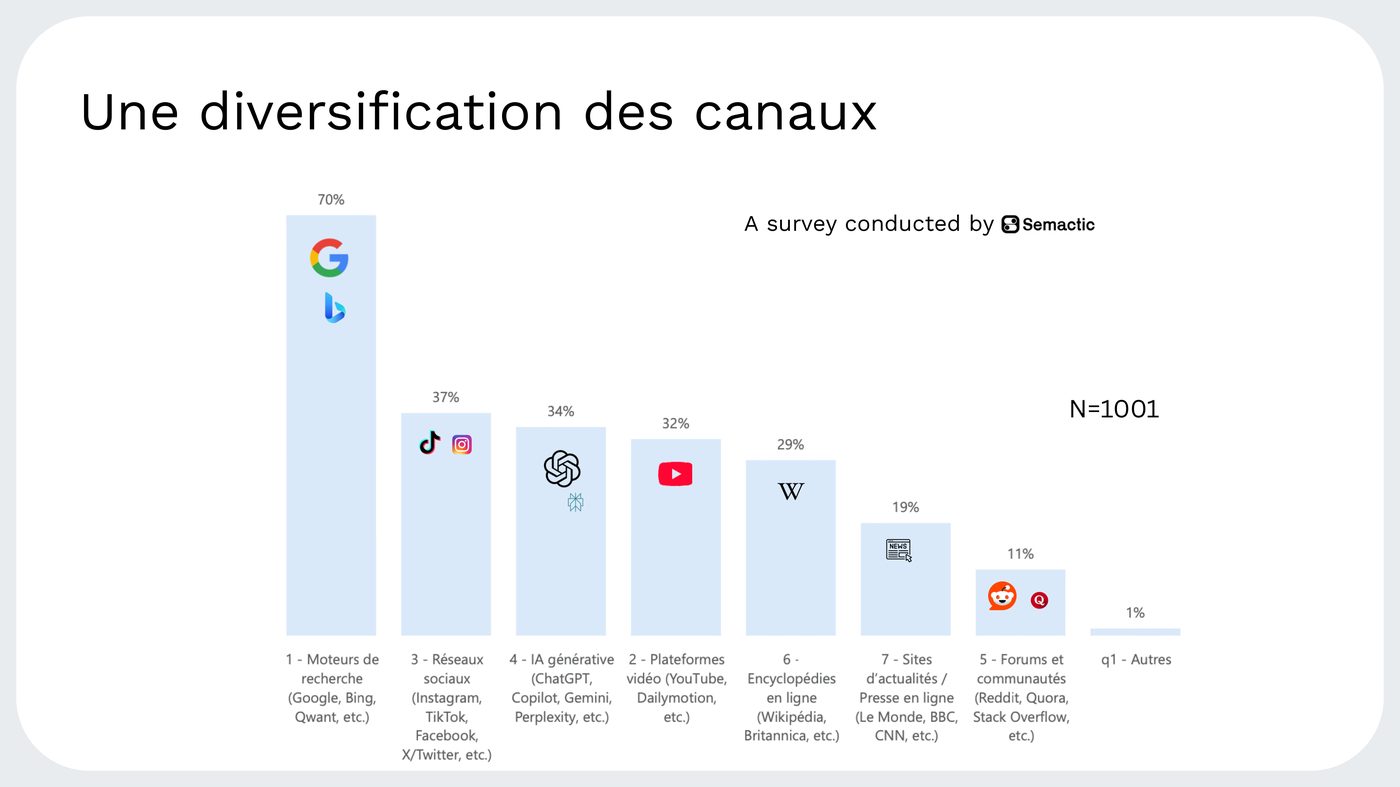
Comment on recherche en ligne aujourd'hui — étude Semactic, panel n = 1001, plusieurs réponses possibles.
Un point de repère chiffré, avant d'entrer dans la distinction SEO/LLM SEO/GEO : sur ce panel, les moteurs de recherche classiques (Google, Bing) restent le canal le plus cité (70%) — mais l'IA générative (ChatGPT, Copilot, Gemini, Perplexity) apparaît déjà en 3ᵉ position (34%), juste derrière les réseaux sociaux (37%) et devant les plateformes vidéo (32%). Cumulés, réseaux sociaux et IA générative (71%) dépassent déjà, sur ce panel, les moteurs de recherche traditionnels.
Deux réserves s'imposent pour lire ce chiffre correctement. D'abord, l'enquête a un an : dans un secteur qui évolue mois par mois, il y a fort à parier que la part de l'IA générative a encore progressé depuis. Ensuite — et c'est sans doute le point le plus important — la frontière entre « moteur de recherche traditionnel » et « réponse IA » s'estompe elle-même, à mesure que Google généralise ses AI Overviews et intègre nativement son AI Mode dans la recherche classique : une partie de ce qui est encore comptée comme « recherche Google » produit déjà, dans les faits, une réponse générative. Compter ces canaux comme parfaitement distincts est donc déjà, en partie, un artefact de mesure — ce qui renforce plutôt qu'il n'affaiblit la nécessité de distinguer clairement SEO, LLM SEO et GEO.
Le SEO « classique » optimise une page pour qu'elle apparaisse parmi les liens organiques d'un moteur de recherche (Google, Bing) : mots-clés, maillage de liens, autorité de domaine, position dans la page de résultats. L'unité de mesure est le classement, et la finalité reste le clic.
Le LLM SEO (parfois appelé AI SEO) désigne l'optimisation en amont : rendre un contenu éligible à l'entraînement des modèles de langage eux-mêmes — le territoire de GPTBot. Un levier de long terme, à l'effet différé et difficilement mesurable campagne par campagne, puisqu'il agit sur la mémoire « paramétrique » du modèle plutôt que sur une réponse ponctuelle.
À ne pas confondre avec l'AIO (AI Optimization), un terme plus récent qui désigne l'usage d'outils IA pour produire et industrialiser du contenu — idéation, rédaction assistée, contrôle qualité automatisé — une démarche de production, pas de visibilité en tant que telle.
L'AEO (Answer Engine Optimization) vise l'inclusion immédiate dans une réponse générée : structurer le contenu — données structurées, formulation question/réponse, traitement du langage naturel — pour qu'il soit repris comme la réponse, sur les featured snippets, les « Autres questions posées » et les AI Overviews de Google comme de Bing.
Le GEO (Generative Engine Optimization) est l'évolution la plus large : il englobe la stratégie de contenu, la structuration et l'accessibilité des données, mais aussi les signaux de réputation et la crédibilité externe de la marque — pour qu'elle soit reconnue comme référence, citée et recommandée dans les contenus générés par l'IA, pas seulement présente dedans. AIO, AEO et LLM SEO ne sont pas des approches concurrentes : ce sont des couches complémentaires d'une même discipline. Comme le résume un article Semactic sur le sujet : vous n'avez plus besoin d'être bien classé, vous devez être la réponse.
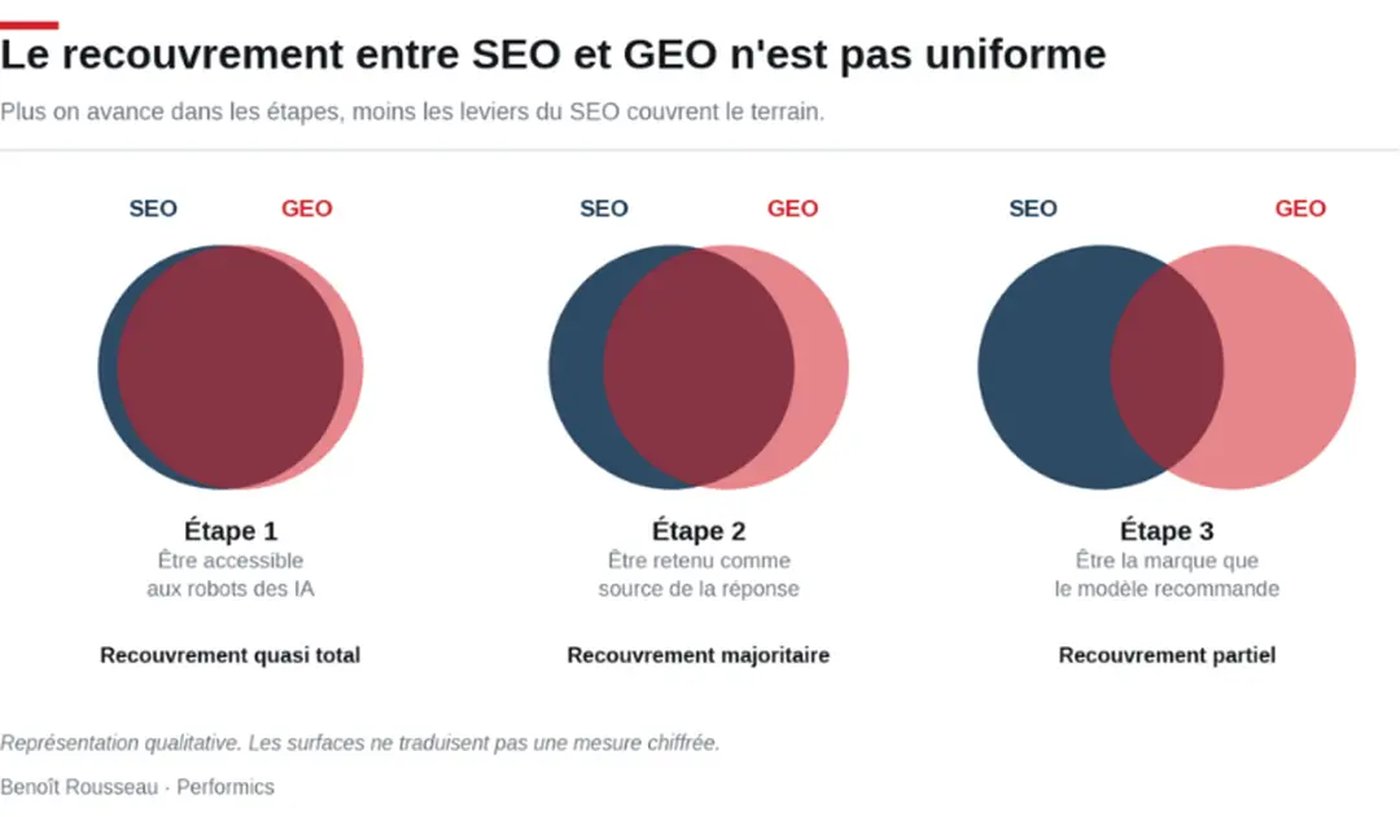
Le recouvrement entre SEO et GEO n'est pas uniforme : il se réduit à mesure que l'on avance dans les étapes. Analyse Benoît Rousseau · Performics.
Cette lecture en trois étapes est plus utile qu'une opposition binaire SEO/GEO : à l'étape 1 (être accessible aux robots des IA), les prérequis techniques du SEO — crawlabilité, vitesse, architecture — servent presque intégralement le GEO. À l'étape 2 (être retenu comme source de la réponse), le recouvrement reste majoritaire mais la structuration sémantique fait la différence. À l'étape 3 (être la marque que le modèle recommande), le recouvrement devient partiel : le classement dans une SERP ne garantit plus rien, seule l'autorité perçue par le modèle compte.
En résumé, en trois points :
Le SEO ne disparaît pas : il reste le socle des trois piliers développés dans ce guide. Ce qui change, c'est la manière de les prioriser une fois qu'on quitte le classement pour la citation.
Comment ChatGPT cherche réellement, ce que l'on sait aujourd'hui de sa mécanique d'indexation, et ce qu'il faut vérifier pour ne pas être exclu avant même d'être évalué.
La logique de la recherche générative. Le cycle se décompose en cinq étapes, quel que soit le moteur génératif : une question est posée ; le modèle la reformule en une liste de sous-questions et de critères pertinents ; une recherche en direct est déclenchée sur les résultats web ; les contenus récupérés sont synthétisés en ne conservant que l'essentiel du contexte d'origine ; une réponse est produite, accompagnée de sources et de liens.
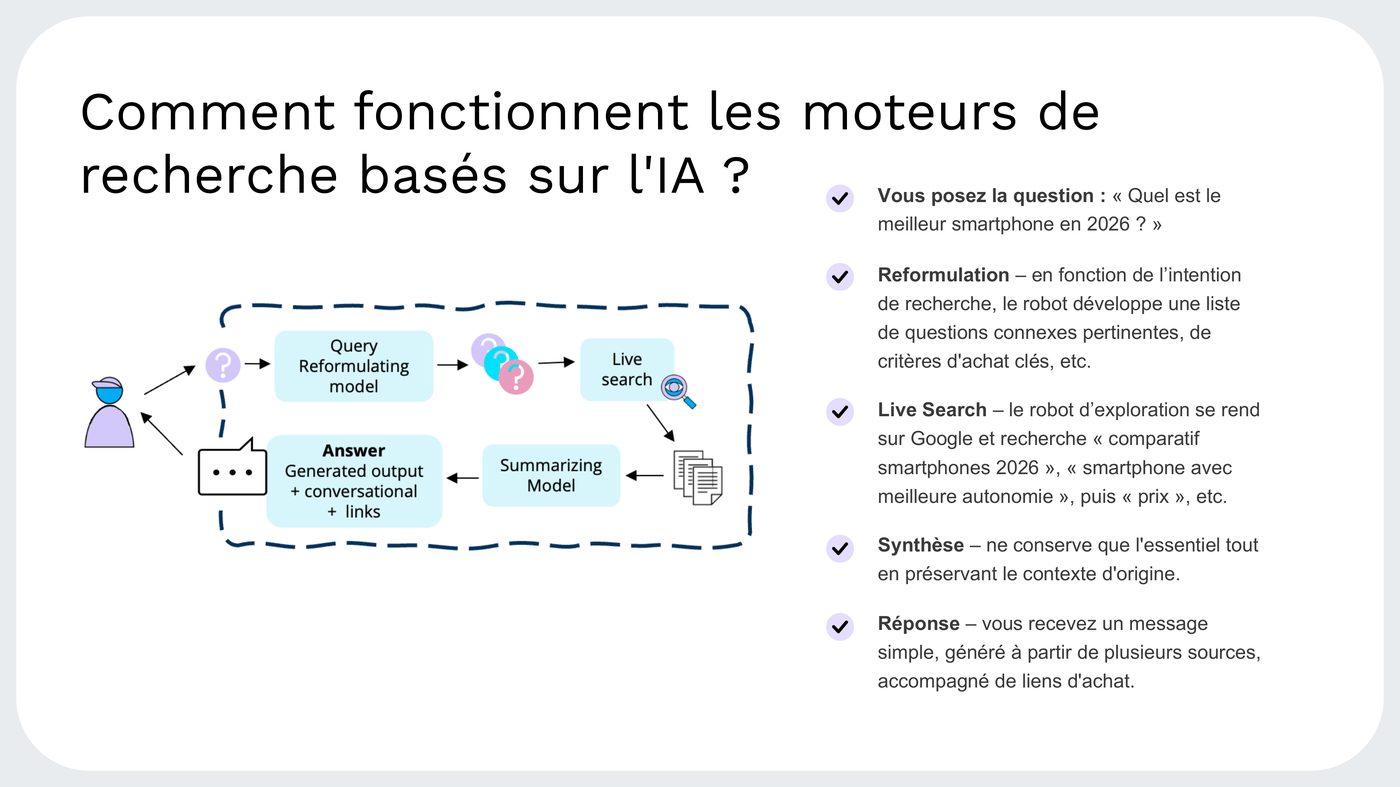
Le cycle en cinq étapes d'un moteur de recherche génératif.
Ce qui change fondamentalement la donne par rapport au SEO classique : le modèle réagit avant même qu'un utilisateur ne clique sur quoi que ce soit. Ce n'est plus une question de classement, mais de présence — et de présence au bon moment du cycle : reformulation, récupération, ou synthèse finale.
C'est ici que ChatGPT diverge le plus nettement des autres moteurs génératifs — et où la situation a le plus évolué en 2026. Pendant près de deux ans, l'hypothèse de travail communément admise dans l'industrie SEO/GEO était simple : ChatGPT n'a pas d'index propre, il sous-traite la recherche à Bing (puis, pour partie, à des fournisseurs tiers) et reformule la question de l'utilisateur en une ou plusieurs requêtes de recherche classiques — un mécanisme que l'industrie a nommé « query fan-out ».
Cette hypothèse doit aujourd'hui être nuancée. Plusieurs faisceaux d'indices, documentés courant 2026, convergent :
web.run ») orchestre plusieurs vagues de requêtes par réponse — de 2-3 pour les modèles rapides à 10 et plus pour les modèles en mode réflexion approfondie — en affinant la requête à chaque itération plutôt qu'en interrogeant un moteur unique.Le consensus le plus prudent, mi-2026 : ChatGPT ne dispose pas d'un index propriétaire aussi mature que celui de Google, mais ne dépend plus non plus d'un unique moteur tiers. Il orchestre un mélange évolutif de fournisseurs de données spécialisés (recherche générale, shopping, actualités, local, cartes…) et d'un index interne encore partiel — ce qui explique la volatilité observée d'un modèle à l'autre : un changement de version peut faire varier de plus de 20% le nombre de domaines uniques cités dans les réponses.
Conséquence pratique. Deux niveaux de visibilité coexistent, et un contenu absent du premier n'atteint jamais le second : la visibilité paramétrique (votre marque existe-t-elle dans les données d'entraînement du modèle — presse, Wikipédia, sites d'autorité ?) conditionne si votre domaine est même candidat à une requête ; la visibilité dynamique (récupération en temps réel) détermine ensuite si le contenu est effectivement extrait. Optimiser uniquement la seconde sans travailler la première revient à soigner une vitrine sur un magasin que personne ne sait chercher.
Méthode de vérification : ouvrez chatgpt.com, activez les outils de développement du navigateur (F12), sélectionnez l'onglet Réseau, posez une question qui déclenche une recherche web, puis repérez dans la réponse de l'API le champ search_model_queries — il contient la requête exacte transmise au moteur sous-jacent, souvent bien plus resserrée que la question initiale (« quel est un bon SUV familial pour rouler en ville ? » devient « meilleur SUV familial usage urbain avis »). C'est cette requête reformulée, et non la question de départ, qui détermine quelles pages sont récupérées.
Quatre prérequis conditionnent l'accès brut à votre contenu, avant même toute question de qualité éditoriale :
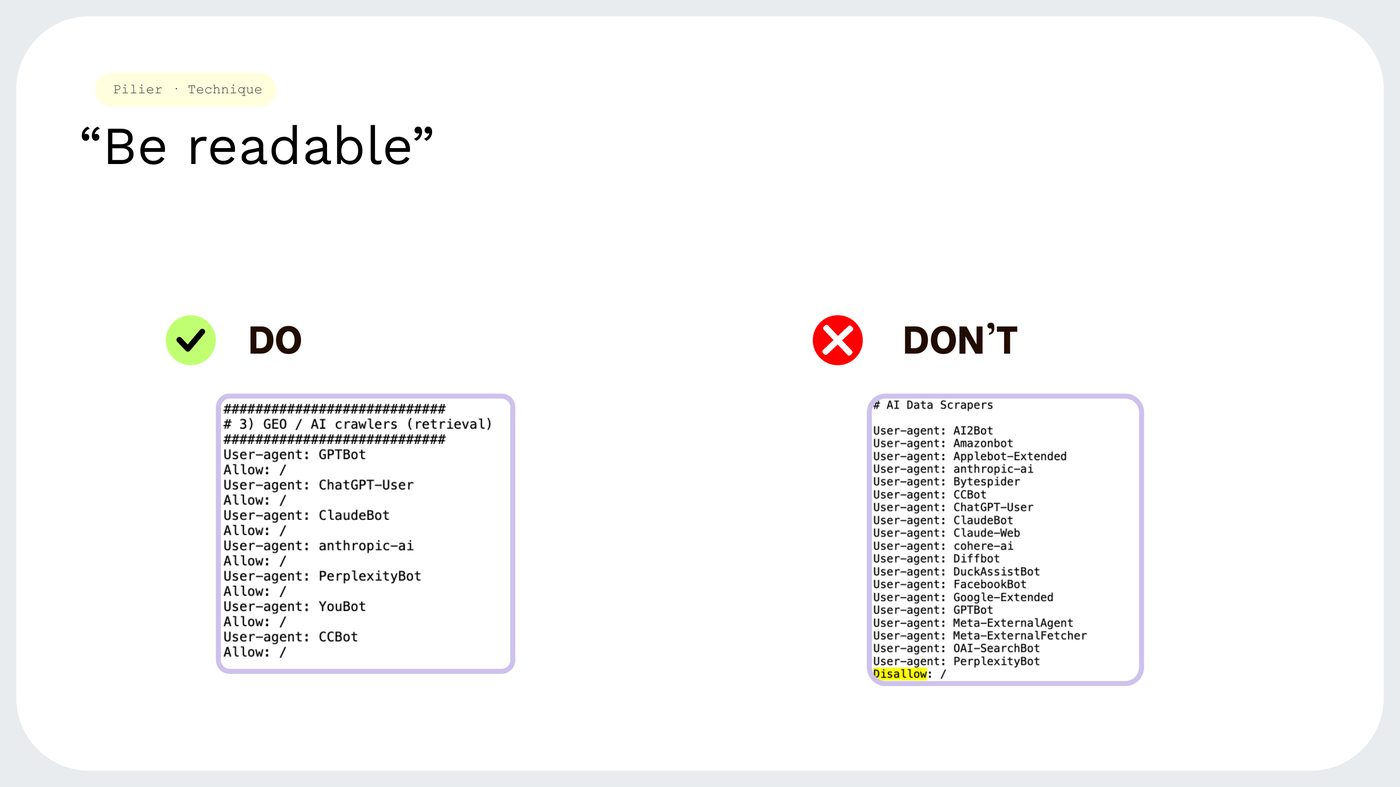
Configuration à faire vs. configuration à éviter pour les robots de retrieval IA.
# Autoriser la recherche générative (GEO / retrieval)
User-agent: OAI-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /

# À décider selon votre politique d'entraînement des modèles
User-agent: GPTBot
Allow: /   # ou Disallow: / si vous refusez l'entraînement sur vos contenus
Le robots.txt n'est qu'une déclaration d'intention : un WAF ou un CDN (Cloudflare en tête) peuvent bloquer ces user-agents en amont, indépendamment du fichier. Faites vérifier les deux couches, avec confirmation écrite de votre agence ou de votre équipe infra — pas un « ça doit être bon ».
Depuis 2025, OpenAI propose aux marchands un programme de flux produit qui alimente directement les fonctions de recherche et de découverte produit au sein de ChatGPT, avec — selon les marchés et l'éligibilité du marchand — une option de paiement intégré. Plutôt que de dépendre de l'indexation passive de vos pages produits, vous poussez vous-même un flux structuré (titres, prix, stock, médias) en HTTPS vers un point d'entrée fourni par OpenAI, aux formats CSV, TSV, XML ou JSON. Un échantillon initial valide la conformité avant mise en production ; une fois validé, les mises à jour peuvent être poussées jusqu'à toutes les 15 minutes.
Pour une marque Mid-Market disposant déjà d'un flux Google Merchant Center ou Meta Catalog, l'effort d'intégration est incrémental. L'option de paiement intégré, quand elle est disponible, impose en revanche des prérequis supplémentaires — intégration conforme au protocole de commerce agentique d'OpenAI et prestataire de paiement vérifié. Un chantier à porter conjointement par l'e-commerce et l'IT, pas une case à cocher marketing.
Une fois le contenu atteignable, encore faut-il qu'il soit organisé pour être extrait, cité, et rattaché sans ambiguïté à votre marque.
Un LLM ne « lit » pas une page comme un visiteur : il l'extrait, souvent par fragments, sans garantie de parcourir l'ensemble du document. La structure qui sert le mieux cette lecture fragmentée est l'architecture en clusters thématiques : une page pilier qui synthétise un sujet, reliée à des pages satellites qui traitent chaque facette en profondeur. C'est cette structure qui permet à un modèle de circuler dans votre corpus plutôt que de s'arrêter à la première page trouvée.
À l'échelle d'une organisation Mid-Market multi-marché, cette structuration ne se traite pas page par page : elle suppose un gabarit de contenu appliqué systématiquement dans le CMS, un audit de couverture par cluster, et une gouvernance claire sur la fraîcheur des contenus — une date de mise à jour visible, et réelle.
Un modèle génératif privilégie les blocs de contenu autonomes : une unité de sens complète en elle-même, qui ne dépend pas du paragraphe précédent pour être comprise.
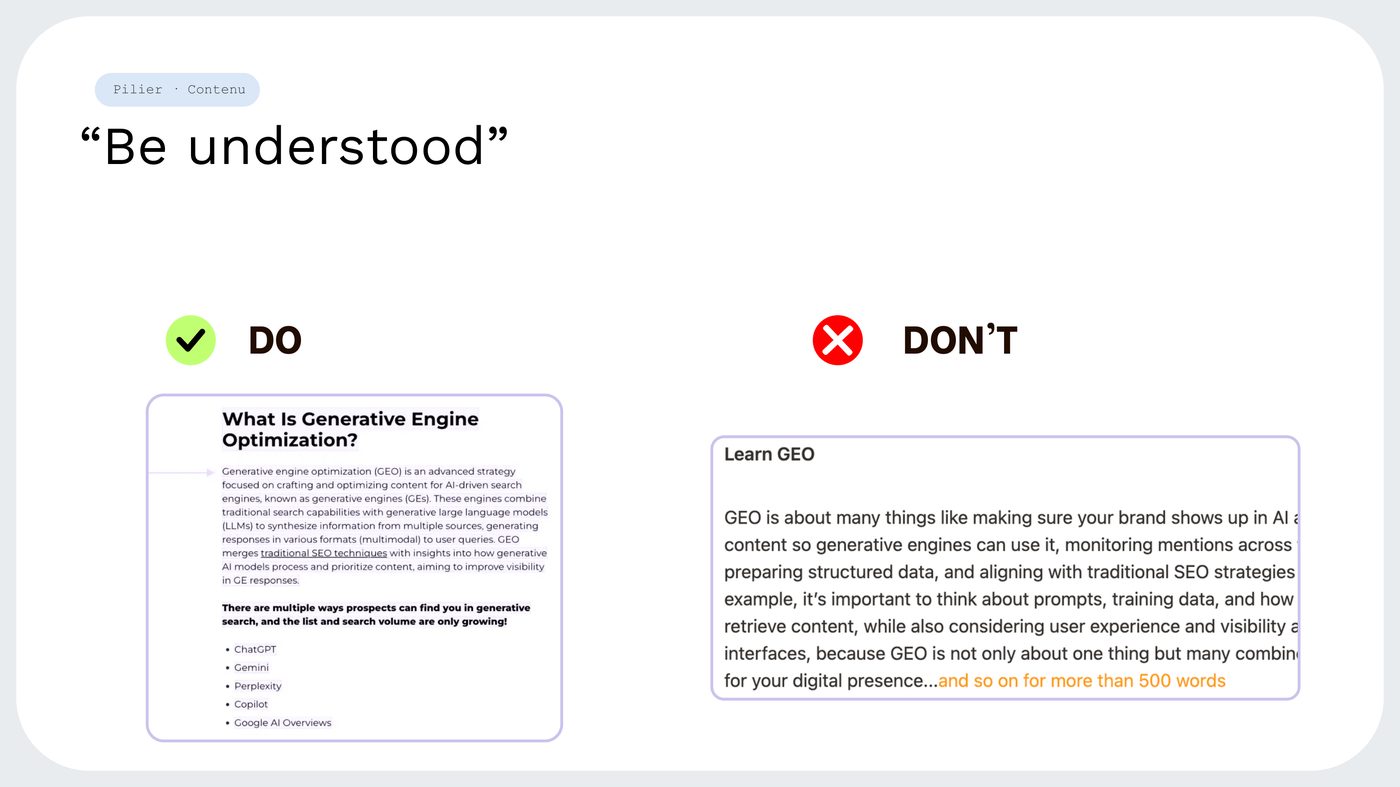
Un bloc autonome et structuré (à gauche) contre un pavé dense de 500 mots (à droite).
Un modèle génératif ne travaille pas avec des mots-clés mais avec des entités : des identités désambiguïsées, rattachées au Knowledge Graph de Google via un identifiant unique (KGMID). Une entité floue — un nom partagé avec quelqu'un d'autre, des attributs incohérents d'un site à l'autre — coupe purement et simplement la visibilité, ou pire, redirige la valeur vers la mauvaise identité. Le cas documenté de Danny Goodwin, dont l'identité professionnelle est restée fusionnée pendant dix ans avec celle d'un joueur de baseball du Hall of Fame dans le Knowledge Graph, illustre le coût réel d'une entité mal établie : une disparition pure et simple du Knowledge Panel.
Trois conditions permettent à un moteur IA de reconnaître correctement une entité — marque ou dirigeant :
En pratique : construisez une « Entity Home » — une page de référence avec balisage schema.org Person ou Organization explicite, ouvrant sur un résumé sans ambiguïté (« [Nom] est [Titre] de [Organisation] ») — puis créez une boucle de corroboration (profils sociaux et annuaires professionnels avec balisage sameAs, cohérence du nom/adresse/téléphone, mentions presse) qui pointe vers cette page avec des attributs identiques. Comptez environ 4 mois pour l'attribution d'un identifiant d'entité stable, et jusqu'à 12 mois pour une reconnaissance pleinement stabilisée.
sameAs)Le pilier le plus souvent sous-estimé — et le plus déterminant à mesure que les moteurs génératifs concentrent leurs citations sur un nombre restreint de sources.
La technique rend un contenu atteignable, la sémantique le rend compréhensible — mais ni l'une ni l'autre ne garantit qu'un modèle génératif choisisse de le citer plutôt qu'un concurrent tout aussi bien structuré. C'est le rôle de l'autorité : les signaux de confiance externes qui font qu'un modèle retient une source plutôt qu'une autre.
Les travaux de référence sur le sujet — l'étude fondatrice « Generative Engine Optimization » de Princeton et IIT Delhi (Aggarwal et al.) — ont mesuré expérimentalement l'effet de différents leviers sur la visibilité d'une source dans une réponse générée : l'ajout de citations et de statistiques vérifiables reste, dans leurs mesures, l'un des leviers isolés les plus efficaces, devant le simple ajout de mots-clés. Autrement dit : un contenu qui cite ses sources et chiffre ses affirmations est mécaniquement mieux retenu qu'un contenu affirmatif non sourcé — l'inverse de nombreux réflexes rédactionnels marketing.
Ce constat rejoint une tendance observée en 2026 sur ChatGPT en particulier : à chaque mise à jour de modèle, le nombre moyen de domaines uniques cités par réponse tend à diminuer, au profit d'un nombre plus restreint de sources jugées les plus fiables — un phénomène que certains praticiens du secteur surnomment l'« effet Bigfoot » (tout le monde en parle, peu de sources concrètes le documentent réellement). Une conséquence directe : être une source correcte ne suffit plus, il faut être une source dont l'autorité est établie ailleurs avant même la requête.
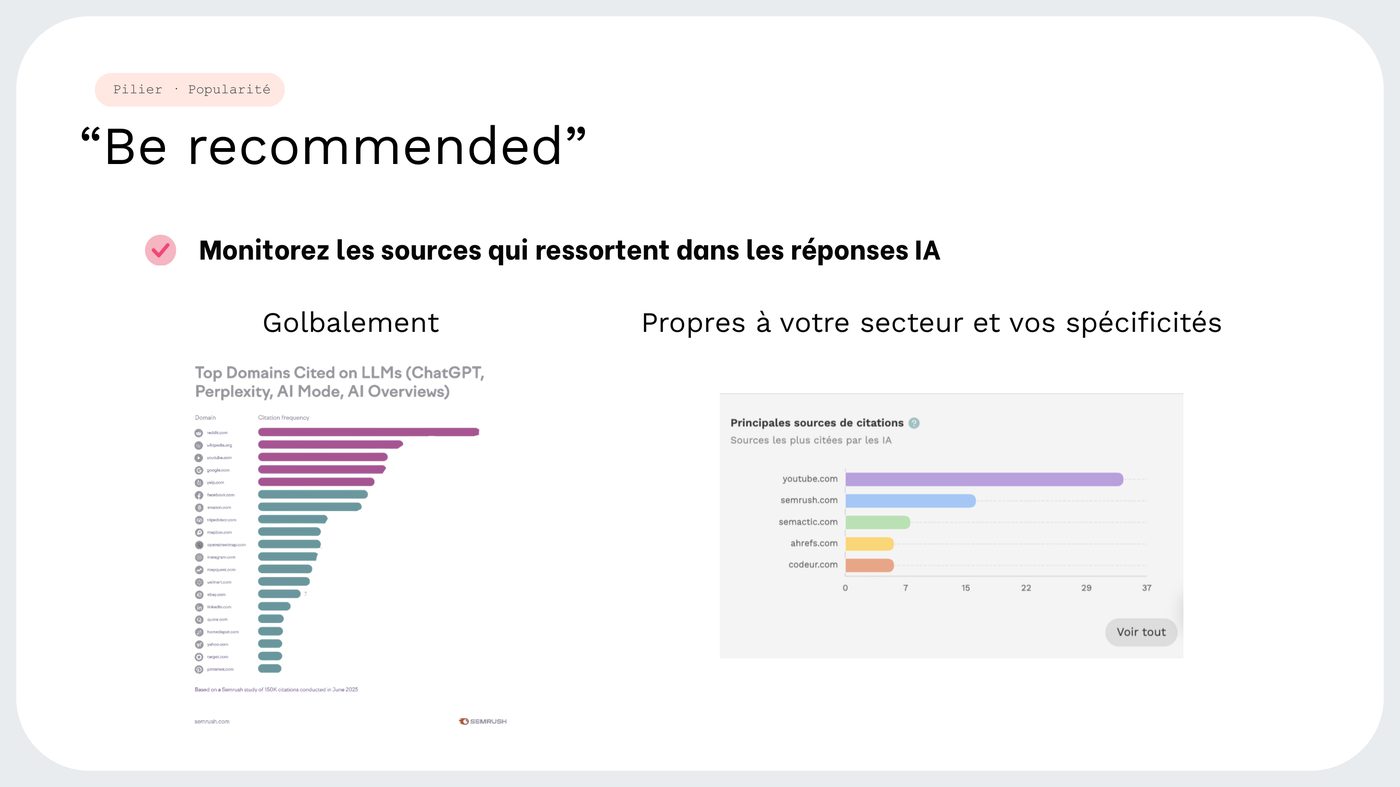
Domaines les plus cités dans les réponses IA — étude Semrush, 150 000 citations, juin 2025.
Cette étude confirme que les domaines les plus cités mêlent plateformes globales (Reddit, Wikipédia, YouTube) et sites d'autorité sectorielle — une place qu'une marque Mid-Market peut occuper sur son propre secteur, sans avoir à concurrencer les géants du classement générique. C'est un point d'autant plus stratégique que 2027 devrait, selon les signaux d'investissement observés côté OpenAI (indexation propriétaire, verticales spécialisées), renforcer encore la sélectivité des sources retenues plutôt que la relâcher.
Une feuille de route qui reprend, dans l'ordre, les trois piliers développés dans ce guide — et la place du SEO classique dans cette équation.
search_model_queries) ce que ChatGPT récupère et affiche réellement de vos pages.Les étapes 4, 5 et 6 fonctionnent en boucle courte, répétée cluster par cluster, plutôt qu'en séquence unique : c'est un chantier continu, pas un projet qui se clôture.
Le SEO ne disparaît pas : sur le panel Semactic, les moteurs de recherche classiques restent le canal le plus utilisé (70%), loin devant l'IA générative (34%). Les fondations qui font un bon SEO — autorité de domaine, maillage, fraîcheur, crawlabilité — sont exactement celles qui alimentent les trois piliers développés dans ce guide. Face à des concurrents mieux dotés en budget ou en notoriété, deux leviers restent à la portée d'une organisation Mid-Market : l'ancrage sectoriel ou géographique (traiter en profondeur un segment précis plutôt que viser un marché générique), et une différenciation affirmée, répétée systématiquement dans les contenus plutôt que diluée dans un discours consensuel du type « nous offrons un service de qualité à tous nos clients ».
Illustration : Daikin, leader du secteur HVAC en Belgique, a confié à Semactic la restructuration de son contenu technique pour la recherche générative - approche par clusters thématiques, blocs de contenu autonomes (≤150 mots), contenu multimodal et mise à jour continue. Résultat : une citation accrue comme source dans ChatGPT et Perplexity sur les requêtes clés du secteur, sans que le SEO traditionnel de la marque n'ait eu à être sacrifié pour y parvenir. Voir l'étude de cas complète →